工厂本体知识库与问答
把工厂的台账、工艺与经验组织成企业自己的本体,让工人用大白话问厂里的事,答案带出处。
解决什么问题
厂里的知识散在三处:台账与系统里、工艺文件里、老师傅脑子里。前两处要找半天,第三处一换人就断。检索只能用关键词,问一句"这个型号的泵上次大修是什么时候、换了什么件",关键词检索答不上来。
系统做什么
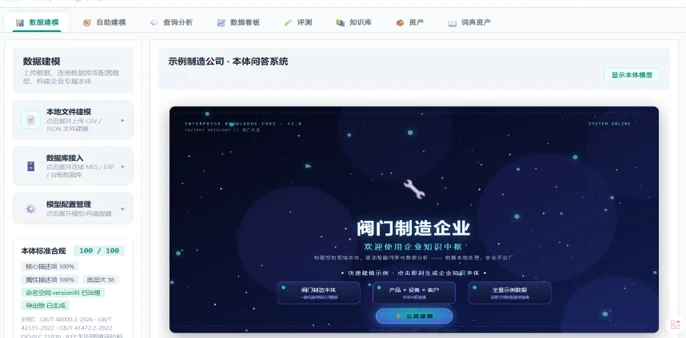
一是建本体。把台账、工艺、设备与经验按关系结构组织起来,明确"谁连着谁",答案的来源是确定的结构,不是模型的猜测。
二是自然语言问答。一线用大白话提问,系统按本体关系取数、按规则判定,再由大模型组织成人能读的一段话。
三是答案带出处。每条回答标注数据来源与时间,可以点进去核对,不需要信任模型的口头承诺。
四是越用越准。日常问答中暴露的缺项与错项沉淀回本体,知识库随使用变厚。
与向量检索的区别
向量检索解决"找相似",本体解决"确定谁连着谁"。工厂场景里大量问题要的是确定答案而不是相似段落,所以两者配合用,判定的部分交给本体与规则。
关于开源
这套系统的核心算法层——本体建模、确定性规则问答、检索与溯源——以 Apache-2.0 完整开源,可自由下载、部署、修改、商用,无需申请许可。仓库不接收任何真实工厂数据,示例一律合成数据;数据不出厂这条红线写进了设计,不是承诺。
行业落地实施由三油科技提供:建模编排、人在环确认、交付打包与持续支持,贴着现场的数据脏、没人标、验收没标准这些真约束做。源码与实测口径见 GitHub 开源项目,边界说明见开源项目页。