

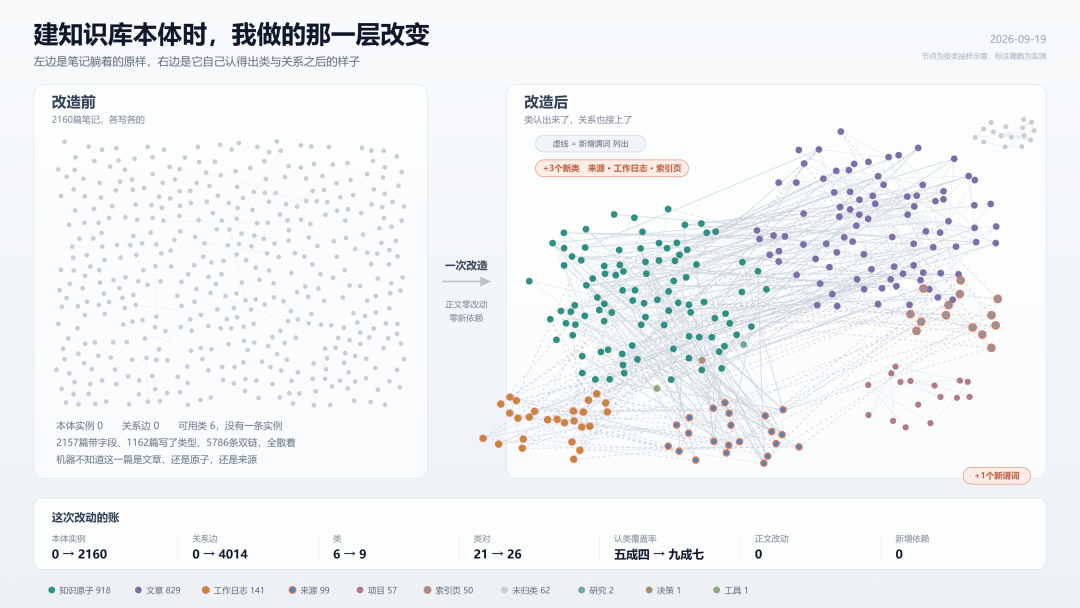
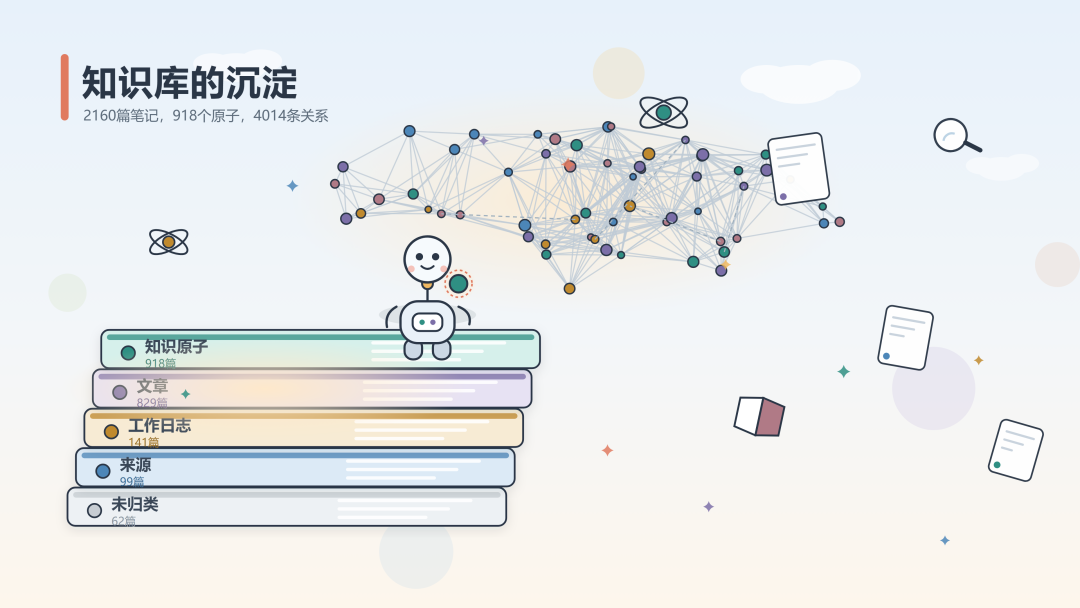
2160篇笔记躺在同一个库里。改造做完,正文一个字没动,它自己分出了918个知识原子、829篇文章、99条来源、141篇工作日志,还有50张索引页。没被认出来的,剩62篇。
多出来的还有4014条语义关系。
这些关系不是新写的,是从库里原本就散着的5786条双链里理出来的。
知识库最常见的毛病,是存得下、串不起来。找得到某一篇,找不到跟它同族的那几篇。
一个做研究的研究员,把自己半年的论文、随手记的笔记和抓来的来源页搬进同一个库。改造之后他查一个概念,回来的除了那篇论文,还有它身上衍出的原子,以及它引用过的来源。
一个学生把四年的课程笔记堆进来。
他搜一次考点,库连带给出同一主题的原子页和那篇总结文章,一次拿走。他不用记得自己写过什么,库记得。
变化落在具体的人身上,才看得出分量。这次改造只干一件事,给库补一副骨架,让机器知道谁是谁。
改动之前,库里其实已经攒了不少结构。2157篇笔记带字段,1162篇写了类型,892篇带知识原子编号,双链有5786条。
难处在于这些结构全是散的。双链只说这两篇提到过对方,不说是什么关系。类型字段各写各的,没有统一的类可以查。
他写下一篇文章的时候,顺手写下的那两条双链,就是这次关系边的原料。当时那只是习惯,没人当它是数据。
检索那一侧只有三样东西在干活,字面匹配、向量相似,再加一个把两边结果合起来的排序。
三样东西都只看像不像,不看是什么。搜一句本体建模,它能还回一篇标题里带本体的文章,却不知道库里还有同一族的调研、原子和方案。
库里其实早立过一副骨架。九月九日留下它的那个人,当时把类、允许的关系、取值范围都写进了一个文件,格式跟共享内核对得上,载入也通过。
他停在了纸面上。文件里没有一条实例,也没有一条关系边。
没有任何程序去读它,它没接进检索,连一次自动校验都没跑过。骨架立在那儿,谁都看得见,谁也用不上。
这就是改造要补的那一刀。
骨架有了,剩下的活是让数据自己走进去。
PART 01

什么是本体

先把本体这个词说清楚。它容易玄乎化,在这个库里其实只有四样东西,一样都不玄。
类是笔记的身份,说得出一篇东西到底算哪种。属性是这类东西身上该有的槽位,比如归档在哪儿、什么时候定的。
谓词是两类东西之间允许存在的关系,比如产出、衍生自、引用、替代。类对是把谓词落到具体的两个类之间,规定谁能对谁说这话。
四样定完,剩下的事交给数据。库里每一篇已经有路径、类型、标签、双链、字段,机器只读这些现成的痕迹,推它是哪一类,再推它跟谁有关系。
PART 02
现有方案的差异
这套思路在国际上不算新。微软的GraphRAG给私有语料建一张知识图谱,配上社区摘要,去回答需要通读全局的问题。
HippoRAG把知识图谱和个性化PageRank放在一起,一步完成多跳检索。作者在NeurIPS 2024上讲过,这套东西模仿的是大脑皮层与海马的分工。
Zep用一张带时间的知识图谱做智能体的长期记忆,在LongMemEval这类基准上验证过。
它们的共同动作都是给语料接一张图。
差别在图的边从哪儿来。
那几套让模型从文本里抽实体与关系,抽得动,也抽得起。这个库选的是另一条路,边从库里已有的双链和目录归属里推,一条都不需要模型去猜。
省下来的是一道核证据的工序。模型抽出来的关系,后面还得有人拿证据去核;从已有痕迹推出来的关系,出处本来就是笔记自己写下的。
PART 03
认类的规则与踩坑
认类这一步,判据只有三条,按优先级往下走。
优先级一:识别码
先看识别码。笔记身上带知识原子编号的,或者归档在概念、实体目录下的,直接判为知识原子。这一类不靠猜,编号就是它的身份。
优先级二:路径与类型
再看路径与类型。路径里带公众号文章字样的,或者字段里写着公众号文的,判为文章。这一条一开始踩过坑。
坑在关键词。最初把路径里出现工具两个字的那篇判成工具类,结果一篇叫AI编程工具的文章被划走了。
关键词太松,它会抢在前头把话说完。改法是让路径前缀先判,关键词退到兜底的位置。改完这一类不再出错。
优先级三:特殊处理聚合页
第三个坑更隐蔽,出在聚合页上。库里有一批索引页,把一个主题下的成员列成一页,光是一张主题索引就写了八百多个成员。
原先它们被判成工作日志,它们指向成员的那些链接,被当成日志衍生自成员。
方向是错的。日志不会衍生出自己列出来的东西,索引页也不是知识本身,它只是一个视图。
这一类被单独拎出来,定成索引页,配一条自己的谓词,叫列出。改完,这批边才站得住。
有人把索引页当成知识本身,他看了一堆目录,以为自己读完了这个主题。这是同一件事的另一种踩法。
PART 04
改造前后的数据变化
数字上的变化很直白。
改造前,来源、日志、报告这三个目录在骨架里没有位置,那里面五百五十条双链,一条边都连不出来。
给它们补上类之后,边从370条涨到4014条。没被认出来的笔记,从351篇降到62篇。
认类覆盖率从五成四上到九成七。新增的类一共三个,来源、工作日志、索引页;谓词加了一个,列出;类对加了五条。
改造前后的关键参数摆在一起,是这样一组数。
参数
改造前
改造后
本体实例
0
2160
关系边
0
4014
具体类
6
9
类对
21
26
谓词
4
5
认类覆盖率
五成四
九成七
能连边的双链
0
3466,其余因类对未声明,有意不建
新增依赖
无
正文改动
无
2160篇笔记这次各自有了身份,分布是这样的:
知识原子918、文章829、工作日志141、来源99、项目57、索引页50、研究2、决策1、工具1、未归类62。
4014条边里,九成是罗列,真正表达内容关系的是370条:
列出3641、引用213、衍生自155、替代2。
罗列那两个数字来自索引页与工作日志,分开记,才不会被一个总数唬住。
写法上有一处值得单独说。索引页可以列出任何一种知识节点,要是把这条关系逐个类写一遍,得写上十几条。
这回第一次用范围基类的写法,把关系的另一头写成基类知识节点,生成的时候自动展开到所有具体类。两条类对,覆盖十几个组合。
PART 05
改造后的检索优化
这些边接进检索以后,第一个动作是扩一跳。检索还回前三条之后,剩下的位置从前三条的邻居里挑。
挑的顺序有讲究。语义关系排在前面,索引与日志这类罗列关系排在末尾。
原先没排序,工程师查一个项目名,第四条补进来的是行业主题索引页,那份东西只是目录,当结果读没有用。
第二个要防的错,是补不满。邻居不够时,结果会从五条缩到三条。这不是扩充,是丢结果。改法是补不满就回填原结果,条数不因为开了这个开关而变少。
维护检索的工程师拿到的是一条开关,加一个环境变量就关掉。他不用打开任何一篇笔记,也不用重写生成器,重建旁挂文件这一步交给每小时的任务。
PART 06
实测结果
参数上的对比要两组一起看,样本是100篇笔记,每种模式各跑200次查询。
命中率(能否找回目标笔记)
检索方式
第一名命中率
前三名命中率
前五名命中率
平均倒数排名
纯语义
80.5%
88.5%
89.5%
0.846
纯字面
79.0%
80.0%
80.0%
0.795
混合
93.0%
94.5%
94.5%
0.937
召回率(能否连带找回同族内容)
指标
邻接扩跳关闭
邻接扩跳开启
邻接召回率
84.0%
100.0%
平均命中邻居数
0.95
1.82
自身仍在结果内
97.0%
97.0%
尾部结果让位数
无
开启后188条,约每次1.88条
命中率那张有一个必须点破的地方。扩一跳开着和关着,它的数字一位小数都没变。
不是扩一跳没起作用,是这张表看不见它。混合检索在前三名上的命中率本来就到了九成四,要找回的那一篇几乎总在前三名里。
扩一跳动的是第四第五位,关掉的时候那里本来就没有命中。指标选错,改造看起来就没有效果,这是这次改造里最值钱的一条经验。
两张表摆在一起,分野就清楚了。
命中率量的是那一篇有没有被准确找到。
召回率量的是该一起回来的同族有没有被带回来,两者在这次改造里的表现完全不同。
换一张表量它真正改的东西,召回率就动了。搜到一篇之后,把它的同族一起带回来的比例,从八成四上到百分之百。
边越多,直检本身就越容易碰到邻居,扩一跳能补的份额越少,可增益一直是正的。同口径再测一遍早期图谱,能看清这条线怎么走。
图谱只有370条边的时候,邻接召回率从58.0%上到99.0%;图谱扩到4014条边,从84.0%上到100.0%。
代价也摆在这里。每次查询平均有一条多的尾部结果被邻居顶掉,换来的是同一族的东西能被一次带回来。
上面这些数字全部来自当日的实测脚本,生成器连跑两遍,产物逐字节一致。外部那三处只做定性提及,没有转引它们的具体数值。
PART 07
改造的核心结论
社区里有篇文章说,图谱好看不等于知识库有用。这句话是对的,因为一张图好不好看,跟它有没有接进检索,本来是两件事。
图摆在那儿没人读,它就只是海报。这次改造里真正产生作用的是接线那一步,骨架只有被检索读到了,才从装饰变成机制。
还有一层意义值得说清。本体不改笔记,它先定下类与关系的边界,再让数据自己去填。
这个顺序不能反。先有类,机器才知道该认什么,才知道哪些关系允许存在,才算得出哪些边是站得住的。
反过来,先让模型随便抽关系,图会很快变大,也会很快变脏。脏的图比没图更难用,因为它看起来什么都有。
PART 08
改造保留的边界
改造留了几条边界,值得一起记住。旁挂文件是快照,新笔记进库之后要重建一次才跟得上,重建已经挂在每小时的任务上。
62篇没被归类的笔记,是运行的说明、脚本记录和杂项,库里没有合适的类,就没硬塞进去。类怎么定是设计决定,不该为了覆盖率好看去凑。
还有一条纪律。边只允许走事先声明过的类对。
类对里没有的组合,宁可少一条边,也不往图里塞一个假词。
还必须说清一处没测到的地方。连带召回这一项测出了提升,找回自己那一项没有变化;要量得更细,得另建带人工判断的评测集。嵌入模型沿用现有的本地模型,没有更换,改造没有触碰向量这一侧。
PART 09
值得记一笔的价值
读到这里你可能会问,那这套东西到底能带来什么。
答案不在图有多漂亮。
研究员查一个概念,一次拿到论文、原子和来源三条线,学生搜一次考点,一次拿走笔记和总结。维护的工程师不用碰任何一篇笔记,只拿一条命令就能重建旁挂文件。
库替他们做的,是记住谁是谁。这件事人在写的时候可能不觉得,但等到库里文章攒到几千篇,就会发现少了它有多难查。